Split CNN Inference: Menggabungkan Kekuatan DPU dan GPU untuk Inferensi AI Super Cepat di Edge
Pelajari bagaimana Split CNN Inference mengoptimalkan kinerja Neural Network di perangkat edge dengan membagi beban kerja antara DPU dan GPU, menghasilkan latensi hingga 3.37x lebih rendah.
Mengapa Inferensi AI di Perangkat Edge Membutuhkan Kecepatan Maksimal?
Dalam era digital saat ini, di mana layanan streaming video dan gambar menjadi tulang punggung banyak aplikasi, kebutuhan akan latensi rendah di perangkat edge (perangkat yang memproses data dekat dengan sumbernya) adalah krusial. Bayangkan kamera pengawas cerdas atau sistem pemantauan lalu lintas yang harus bereaksi secara real-time; setiap milidetik sangat berarti. Untuk memenuhi tuntutan ini, Neural Networks (NN), khususnya Convolutional Neural Networks (CNN), telah menjadi pilihan utama dalam aplikasi pemrosesan gambar dan visi komputer. Sejak kemunculan LeNet-5 pada tahun 1998 dan kemudian dengan AlexNet pada tahun 2012 yang mencapai titik balik dalam kompetisi ImageNet, CNN telah terbukti sangat efektif dalam berbagai masalah seperti pengenalan digit tulisan tangan, deteksi objek, klasifikasi objek, hingga segmentasi gambar.
Secara tradisional, upaya untuk mempercepat inferensi (proses di mana model AI membuat prediksi) pada CNN terfokus pada penggunaan satu unit perangkat keras akselerator, seperti Graphics Processing Unit (GPU), Field Programmable Gate Array (FPGA), atau Deep Learning Processing Unit (DPU). Namun, pendekatan ini mungkin tidak selalu optimal karena setiap akselerator memiliki kelebihan dan kekurangannya sendiri, dan pola komputasi yang berbeda di berbagai bagian inferensi CNN. Keterbatasan ini mendorong inovasi baru dalam arsitektur inferensi, yaitu dengan menggabungkan kekuatan lebih dari satu jenis akselerator.
DPU dan GPU: Kekuatan Akselerasi di Tangan Anda
DPU dan GPU adalah dua jenis akselerator perangkat keras yang dirancang untuk tugas komputasi intensif, yang sangat penting dalam beban kerja deep learning. GPU, seperti NVIDIA RTX 2080 yang digunakan dalam penelitian ini, telah lama dikenal karena kemampuannya dalam pemrosesan paralel yang masif, menjadikannya ideal untuk pelatihan dan inferensi model AI yang besar. Pola akses memorinya yang dapat diprediksi dan sifat komputasinya yang paralel menjadikan GPU sangat berharga untuk beban kerja CNN.
Di sisi lain, DPU, terutama yang terintegrasi dalam perangkat FPGA modern seperti Versal VCK190 dari AMD, merupakan unit akselerator neural yang lebih spesifik. DPU dirancang untuk memproses data AI secara sangat efisien, seringkali "dekat dengan sumber data" (misalnya, dekat dengan sensor kamera atau penyimpanan). Ini memungkinkannya untuk melakukan pemrosesan awal gambar masukan secara lokal sebelum data dikirim lebih jauh. Kombinasi DPU dan GPU ini menghadirkan potensi besar. DPU dapat menangani lapisan awal CNN yang seringkali terkait dengan pra-pemrosesan dan ekstraksi fitur awal, sementara GPU dapat mengambil alih lapisan yang lebih kompleks yang memerlukan daya komputasi paralel yang lebih besar.
Mengenal Split CNN Inference: Mengoptimalkan Beban Kerja Neural Network
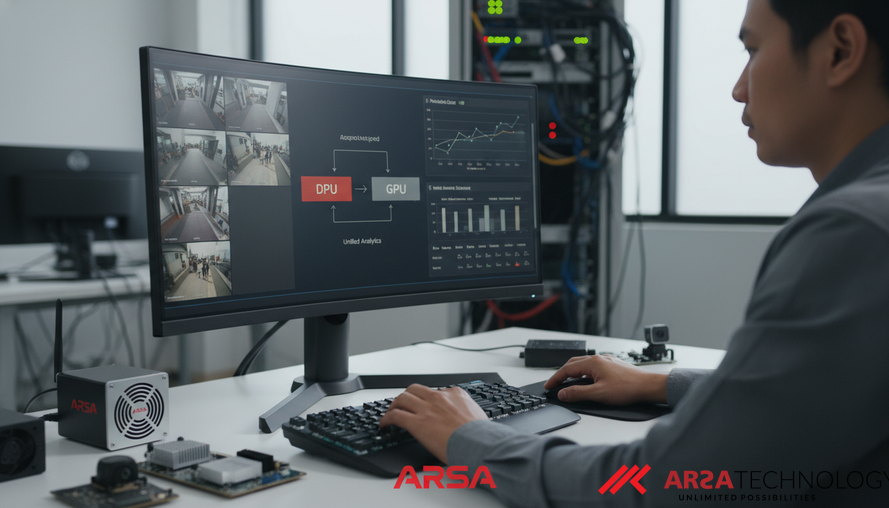
Penelitian ini memperkenalkan pendekatan inovatif yang disebut "Split CNN Inference", di mana inferensi CNN dibagi dan dijalankan secara paralel pada DPU dan GPU. Gagasan utamanya adalah memanfaatkan keunggulan masing-masing unit pemrosesan. Tahap pertama dari inferensi, yang melibatkan lapisan-lapisan awal CNN yang memproses gambar masukan, dijalankan pada AI engine (DPU) di perangkat FPGA. Keunggulan DPU dalam memproses data "dekat sumber" berarti latensi transfer data dari sensor (misalnya, kamera) dapat diminimalkan.
Setelah DPU menyelesaikan pemrosesan bagian pertama, hasilnya akan dialirkan ke GPU secara pipelined dan asinkron. Ini berarti GPU dapat memulai pemrosesan bagian kedua bahkan sebelum DPU sepenuhnya selesai dengan semua tugasnya. Dengan cara ini, data yang ditransfer dari sumber data ke GPU berkurang, karena sebagian besar pemrosesan awal telah dilakukan oleh DPU. Sistem ini telah diuji dengan model-model CNN yang dikenal luas seperti LeNet-5, ResNet18/50/101/152, VGG16, dan MobileNetv2. Pendekatan ini secara signifikan mengurangi latensi keseluruhan dan meningkatkan efisiensi. Untuk solusi AI edge yang andal, seperti yang ditawarkan oleh ARSA AI Box Series, strategi ini dapat diterjemahkan menjadi kinerja yang lebih responsif dan hemat sumber daya.
Aplikasi Praktis dan Peningkatan Kinerja yang Signifikan
Implementasi Split CNN Inference memiliki implikasi praktis yang luas di berbagai industri, terutama untuk aplikasi yang membutuhkan pemrosesan real-time dan latensi rendah di perangkat edge.
- Visi Komputer Industri: Dalam manufaktur, deteksi cacat produk atau pemantauan kepatuhan keselamatan (misalnya, penggunaan Alat Pelindung Diri/APD) memerlukan analisis gambar yang sangat cepat. Dengan Split CNN Inference, pabrik dapat mencapai kecepatan respons yang lebih tinggi, meningkatkan keamanan dan kualitas produk.
Kota Cerdas dan Transportasi: Sistem pemantauan lalu lintas atau pengawasan kota cerdas dapat menganalisis kepadatan kendaraan, mengidentifikasi insiden, atau menghitung jumlah orang secara real-time*. Peningkatan latensi yang signifikan (hingga 3.37x lebih cepat dibandingkan hanya GPU dan 2.48x lebih cepat dibandingkan hanya DPU) memungkinkan pengambilan keputusan yang lebih cepat, seperti penyesuaian sinyal lalu lintas atau respons darurat.
- Ritel dan Perhotelan: Analisis perilaku pelanggan, penghitungan pengunjung, atau manajemen antrean dapat dilakukan dengan lebih akurat dan cepat, membantu bisnis mengoptimalkan tata letak toko dan strategi pemasaran. Solusi AI Video Analytics yang memanfaatkan arsitektur seperti ini dapat mengubah data CCTV pasif menjadi wawasan operasional yang dapat ditindaklanjuti.
Penelitian oleh Oztas et al. dari The University of Manchester ini menunjukkan bahwa pendekatan gabungan ini mampu memberikan peningkatan latensi yang substansial. Hasil studi menunjukkan peningkatan latensi hingga 2.48 kali lipat dibandingkan dengan eksekusi hanya DPU, dan hingga 3.37 kali lipat dibandingkan dengan eksekusi hanya GPU (Oztas et al., 2026, https://arxiv.org/abs/2605.00174). Ini membuktikan bahwa membagi beban kerja secara cerdas di antara akselerator yang berbeda bukanlah sekadar ide teoretis, tetapi solusi yang memberikan hasil nyata di lingkungan produksi.
GNN: Kunci Otomatisasi Pembagian Lapisan CNN
Salah satu tantangan terbesar dalam membagi inferensi CNN di antara akselerator yang berbeda adalah menemukan "titik partisi" yang optimal. Menentukan lapisan mana yang harus berjalan di DPU dan lapisan mana yang di GPU memerlukan pemahaman mendalam tentang arsitektur CNN dan karakteristik kinerja setiap akselerator. Melakukan pencarian menyeluruh (exhaustive search) untuk setiap model CNN dan konfigurasi perangkat keras bisa jadi sangat memakan waktu dan tidak praktis, terutama dalam skenario pengembangan yang cepat.
Untuk mengatasi ini, penelitian ini mengusulkan metode prediksi indeks partisi berbasis Graph Neural Network (GNN). GNN adalah jenis neural network yang dirancang untuk memproses data yang direpresentasikan sebagai grafik. Dalam konteks ini, GNN dilatih untuk memahami struktur CNN dan secara otomatis memprediksi titik partisi terbaik antara DPU dan GPU. Model GNN yang terlatih ini menunjukkan akurasi yang mengesankan, yaitu 96.27% dalam membagi lapisan antara perangkat yang sesuai relatif terhadap hasil partisi optimal yang ditemukan melalui pencarian menyeluruh. Ini berarti pengembang dan insinyur dapat dengan cepat mengimplementasikan Split CNN Inference tanpa perlu melakukan optimasi manual yang rumit untuk setiap model atau setup baru. Pendekatan ini membuka jalan bagi implementasi AI yang lebih gesit dan efisien di perangkat edge, memungkinkan solusi AI kustom beradaptasi dengan cepat terhadap persyaratan kinerja yang berubah.
Kesimpulan: Membangun Masa Depan Inferensi AI yang Lebih Cepat dan Efisien
Pendekatan Split CNN Inference, yang secara cerdas membagi beban kerja model Convolutional Neural Network antara DPU dan GPU, merupakan langkah maju yang signifikan dalam mengoptimalkan inferensi AI, khususnya untuk aplikasi yang membutuhkan latensi ultra-rendah di perangkat edge. Dengan memanfaatkan keunggulan unik dari setiap akselerator – DPU untuk pemrosesan data awal yang dekat dengan sumber, dan GPU untuk komputasi paralel intensif – sistem ini tidak hanya mengurangi latensi secara dramatis tetapi juga meningkatkan efisiensi operasional secara keseluruhan.
Lebih lanjut, integrasi Graph Neural Network untuk mengotomatiskan proses partisi menghadirkan efisiensi yang belum pernah ada sebelumnya dalam penerapan solusi AI. Ini memungkinkan perusahaan untuk menyebarkan sistem AI yang lebih cepat, lebih andal, dan lebih hemat biaya di berbagai industri, dari manufaktur hingga kota cerdas. ARSA Technology, dengan keahliannya dalam solusi AI & IoT, berkomitmen untuk menghadirkan inovasi semacam ini ke dunia nyata, membantu perusahaan global mencapai efisiensi dan keamanan operasional yang tak tertandingi.
Siap untuk merasakan kekuatan inferensi AI yang lebih cepat dan efisien? Jelajahi solusi AI & IoT kami dan hubungi tim ARSA untuk konsultasi gratis.